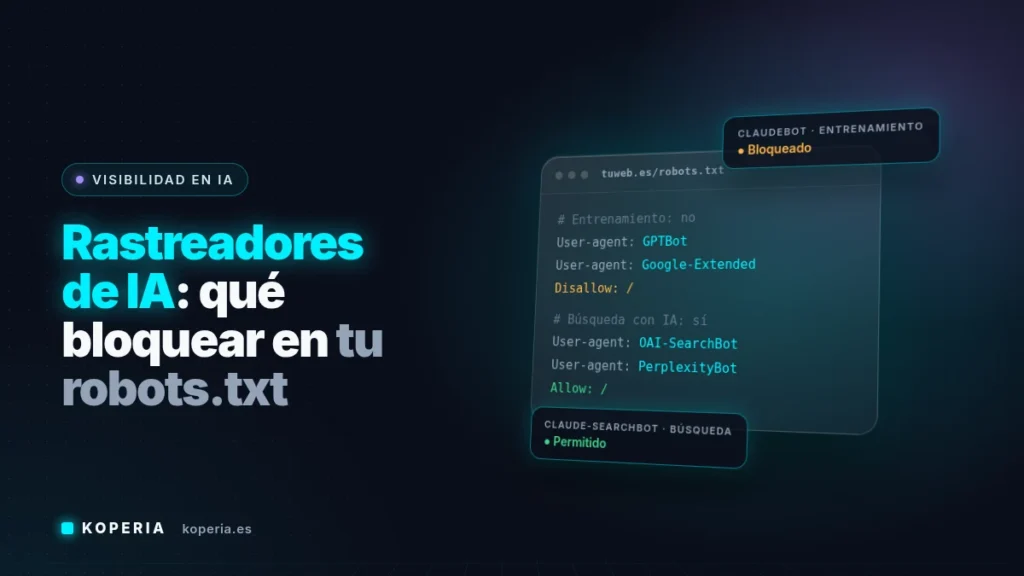
Los rastreadores de IA son los robots con los que OpenAI, Google, Anthropic, Perplexity o Apple leen tu web, y cada uno tiene su propio nombre en robots.txt. Según la documentación de cada empresa, consultada en octubre de 2026, bloquear los de entrenamiento no te saca de las respuestas de la IA; bloquear los de búsqueda, sí.
A cualquier web le llegan desde hace tiempo visitas de robots que no son de Google: GPTBot, ClaudeBot, PerplexityBot y una lista que crece cada pocos meses. Muchas empresas se enteran cuando su hosting o Cloudflare les pregunta si quieren bloquear «los bots de IA», o cuando leen que hay que crear un archivo llms.txt para salir en ChatGPT.
El problema es que la pregunta está mal planteada. No hay un solo rastreador de IA por empresa: cada una tiene varios y cada uno hace una cosa distinta. Uno recoge textos para entrenar modelos, otro alimenta el buscador del asistente y otro entra en tu página porque un usuario se lo ha pedido. Si bloqueas todos los rastreadores de IA a la vez, puedes desaparecer de las respuestas en las que quieres salir. Si los dejas pasar todos, tus textos pueden acabar entrenando modelos.
Esta guía explica qué hace cada rastreador de IA, qué controla de verdad robots.txt y qué no, para qué sirve llms.txt y cómo decidir en cinco pasos a quién dejas pasar.
Contenido
💡 Idea clave: entrenar y citar son cosas distintas. Puedes negarte a que tu web entrene modelos y, a la vez, querer que los asistentes de IA te encuentren y te enlacen.
¿Qué son los rastreadores de IA?
Los rastreadores de IA son programas automáticos que visitan páginas web para que una empresa de inteligencia artificial pueda usar su contenido: para entrenar modelos, para responder con información actualizada o para atender la petición concreta de un usuario. Cada uno se identifica con un nombre, el user-agent, y ese nombre es el que se escribe en robots.txt para darle instrucciones.
Hay tres tipos, y la diferencia importa más que la marca:
- De entrenamiento. Recogen textos que pueden usarse para entrenar futuros modelos, como GPTBot de OpenAI o ClaudeBot de Anthropic. Google-Extended y Applebot-Extended no son robots aparte: Google y Apple rastrean con sus robots de siempre y usan esa línea de robots.txt para saber si pueden entrenar con lo que han leído.
- De búsqueda. Indexan páginas para que el asistente pueda citarlas y enlazarlas en sus respuestas: OAI-SearchBot para ChatGPT, Claude-SearchBot y PerplexityBot.
- De petición de usuario. Entran en una página concreta porque alguien le ha pedido al asistente que la lea: ChatGPT-User, Claude-User y Perplexity-User.
¿Qué rastreadores de IA hay y cuáles respetan robots.txt?
Estos son los principales rastreadores de IA, con lo que dice cada empresa en su documentación oficial, consultada en octubre de 2026:
| Empresa | Nombre en robots.txt | Para qué lo usa | ¿Respeta robots.txt? |
|---|---|---|---|
| OpenAI | GPTBot | Entrenar sus modelos | Sí |
| OpenAI | OAI-SearchBot | Mostrar webs en las búsquedas de ChatGPT | Sí; los cambios tardan unas 24 horas |
| OpenAI | ChatGPT-User | Acciones que pide un usuario en ChatGPT o en un GPT | No siempre: OpenAI avisa de que puede no aplicarse |
| Anthropic | ClaudeBot | Recoger contenido que puede servir para entrenar | Sí |
| Anthropic | Claude-SearchBot | Mejorar los resultados de búsqueda de Claude | Sí |
| Anthropic | Claude-User | Entrar en webs cuando un usuario pregunta | Sí |
| Perplexity | PerplexityBot | Mostrar y enlazar webs en sus resultados; no entrena modelos | Sí |
| Perplexity | Perplexity-User | Peticiones de usuarios | En general, no |
| Google-Extended | Entrenar Gemini; no afecta a Google Search | Sí (es una regla, no un robot) | |
| Apple | Applebot-Extended | Entrenar sus modelos; no afecta a su buscador | Sí (es una regla, no un robot) |
Hay dos ausencias que confunden. Google no tiene un robot propio para los AI Overviews ni para el Modo IA: usan lo que rastrea Googlebot, el de la búsqueda normal. Microsoft tampoco publica un robot aparte para Copilot; controla el uso de tu contenido con etiquetas en las páginas que rastrea Bingbot. Por eso bloquear Google-Extended no te saca de los AI Overviews, y bloquear Googlebot te saca de Google entero.
💡 Idea clave: Google-Extended decide si tu web entrena Gemini, no si apareces en los AI Overviews. Para eso Google tiene otros controles, y no están en robots.txt.
¿Cómo controlo si salgo en los AI Overviews y en el Modo IA de Google?
Desde el 31 de agosto de 2026, Search Console tiene un control propio para esto, disponible para todas las webs según la ayuda de Google. En los ajustes, el apartado de IA generativa de la búsqueda te deja incluir la web (la opción por defecto) o excluirla de los AI Overviews, del Modo IA y de las funciones de IA generativa de Discover. Excluirla no te saca del índice ni cambia tu posición en los resultados normales. Google aclara además que este control no afecta al entrenamiento de modelos: para eso sigue estando Google-Extended.
El otro camino es el de siempre. Las etiquetas nosnippet, data-nosnippet y max-snippet limitan qué fragmentos de tu página puede mostrar Google, también en sus funciones de IA, según su guía sobre las funciones de IA y tu web. Sirven si quieres proteger una parte concreta, como una tarifa o un texto de pago, sin salir del todo.
En Bing, Microsoft anunció en septiembre de 2023 dos etiquetas para su chat, hoy Copilot. Con NOCACHE solo puede mostrar la URL, el título y el fragmento de tu página; con NOARCHIVE no la incluye en sus respuestas ni la usa para entrenar sus modelos.
¿Qué es llms.txt y sirve para algo?
llms.txt es un archivo en formato Markdown que se coloca en la raíz de la web (tuweb.es/llms.txt) con un resumen del sitio y una lista de enlaces a sus páginas más útiles, pensado para que un modelo de lenguaje entienda el sitio de un vistazo. Lo propuso Jeremy Howard en 2024 y es eso, una propuesta, no un estándar.
Google lo deja claro en su guía de optimización para IA, actualizada en julio de 2026: no hace falta crear archivos de texto para IA, marcado especial ni Markdown para aparecer en Google Search ni en sus funciones de IA, porque Google Search no los usa. Ni ayudan ni perjudican.
Nuestra recomendación: si tu plugin de SEO lo genera solo, déjalo, no estorba. En koperia.es lo crea Rank Math automáticamente con la lista de artículos, y no esperamos de él ningún efecto en Google. Lo que no compensa es pagar a nadie por «optimizar tu llms.txt».
Cómo decidir qué rastreadores de IA bloquear, paso a paso
- Mira qué tienes hoy. Abre tuweb.es/robots.txt en el navegador. En WordPress suele haber solo unas líneas para la carpeta /wp-admin/ y la dirección del sitemap, y eso significa que todos los rastreadores de IA pueden pasar. Es lo que tiene ahora mismo koperia.es.
- Revisa si alguien bloquea por ti. Si tu web pasa por Cloudflare, mira su panel: desde julio de 2025 ofrece bloquear los rastreadores de IA por defecto en los dominios nuevos, y su robots.txt gestionado añade reglas para GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot y otros. Algunos hostings y plugins de seguridad hacen algo parecido sin avisar.
- Decide por separado entrenamiento y búsqueda. Si quieres que te encuentren, deja pasar siempre los de búsqueda. Lo del entrenamiento es una decisión de negocio: si tu contenido es tu producto (cursos, informes de pago, un medio), tiene sentido bloquearlo; si tu contenido sirve para dar a conocer tus servicios, ganas poco bloqueándolo.
- Escribe las reglas. Cada grupo empieza con una o varias líneas User-agent y sigue con sus Disallow (no entres) o Allow (entra). Tienes un ejemplo justo debajo.
- Comprueba y apúntate revisarlo. Vuelve a abrir el archivo en el navegador, mira el informe de robots.txt de Search Console por si hay errores y revisa la lista de nombres cada seis meses: aparecen rastreadores de IA nuevos y algunos cambian de función.
Ejemplo ilustrativo de robots.txt para una empresa de servicios que no quiere que su web entrene modelos pero sí quiere aparecer en los buscadores con IA:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Entrenamiento de modelos: no
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

# Búsqueda con IA: sí (repetimos /wp-admin/ porque este bloque
# sustituye al de User-agent: * para estos tres robots)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://tuweb.es/sitemap_index.xml
Un detalle que se olvida mucho: un robot que tiene su propio grupo deja de leer el de User-agent: *. Por eso el ejemplo repite la regla de /wp-admin/ para los robots de búsqueda. Y recuerda que robots.txt es una petición, no un candado: Google lo dice en su introducción a robots.txt, que no sirve para ocultar una página. Lo privado va con contraseña o con noindex.
¿Bloquear los rastreadores de IA tiene valor legal?
Tiene valor como señal, y en Europa más que en otros sitios. La directiva europea de derechos de autor de 2019 permite a los titulares reservarse el uso de sus contenidos para minería de textos y datos por medios de lectura mecánica. Y el Código de buenas prácticas para modelos de IA de uso general que publicó la Comisión Europea el 10 de julio de 2025 compromete a quienes lo firman a usar rastreadores que lean y respeten robots.txt.
En la práctica, bloquear los rastreadores de IA de entrenamiento (GPTBot, ClaudeBot o Google-Extended) es una forma de dejar escrito que no autorizas ese uso. No es asesoramiento legal: si tu contenido tiene valor comercial propio, confirma el alcance con un abogado de propiedad intelectual.
¿Cuándo NO conviene tocar el robots.txt?
- Si tu web es tu escaparate. Una empresa de servicios cuyo blog existe para que la encuentren gana poco bloqueando el entrenamiento, y puede perder mucho si se equivoca de nombre y bloquea la búsqueda.
- Si lo que quieres es salir de los AI Overviews. robots.txt no es la herramienta: usa el control de Search Console o las etiquetas de fragmentos.
- Si quieres proteger datos privados. Ni robots.txt ni llms.txt protegen nada. Lo privado va detrás de un acceso con contraseña.
- Si nadie va a mantenerlo. Una lista de bloqueos copiada de internet y olvidada envejece mal: los nombres de los rastreadores de IA cambian y aparecen otros.
💡 Idea clave: un robots.txt que bloquea por error OAI-SearchBot o PerplexityBot te borra de esos buscadores sin que nadie te avise. Cada línea tiene que tener un motivo.
Errores frecuentes con los rastreadores de IA
- Bloquear Googlebot para salir de los AI Overviews. Consecuencia: desapareces de Google entero, no solo de sus respuestas con IA.
- Creer que bloquear Google-Extended te quita de los AI Overviews. Consecuencia: solo dejas de entrenar Gemini; tu contenido sigue apareciendo en las respuestas.
- Meter a todos los rastreadores de IA en el mismo saco. Consecuencia: al bloquear «todos los bots de IA» con un plugin o un interruptor del hosting, puedes cerrar también los de búsqueda y dejar de salir en ChatGPT o Perplexity.
- Olvidar que un grupo propio anula el general. Consecuencia: un robot con su propia línea User-agent ya no lee las reglas de
User-agent: *y puede entrar en carpetas que creías cerradas. - Esperar resultados de llms.txt en Google. Consecuencia: horas invertidas en un archivo que Google Search ignora, según su propia guía.
- Escribir mal el nombre. Consecuencia: «GPT-Bot» u «OAISearchBot» no corresponden a ningún robot y la regla no hace nada. Copia los nombres de la documentación oficial de cada empresa.
Cómo lo hacemos en Koperia
Dentro del servicio de posicionamiento en IA revisamos tu robots.txt, lo que tenga configurado tu hosting o Cloudflare y tus ajustes en Search Console y Bing Webmaster Tools, y te decimos qué rastreadores de IA entran hoy en tu web y cuáles se están quedando fuera sin que lo sepas. La decisión de qué bloquear es tuya; nosotros te explicamos qué pasa con cada opción. Si estás empezando, lee antes la guía para aparecer en ChatGPT y la de cómo comprobar qué dice ChatGPT de tu empresa.
Preguntas frecuentes sobre los rastreadores de IA
¿Si bloqueo GPTBot dejo de salir en ChatGPT?
No. GPTBot solo recoge contenido para entrenar los modelos de OpenAI. Lo que permite que ChatGPT muestre y enlace tu web en sus búsquedas es OAI-SearchBot, un rastreador distinto con su propia regla en robots.txt. Puedes bloquear el primero y permitir el segundo. Según la documentación de OpenAI, los cambios en robots.txt tardan unas 24 horas en aplicarse en sus sistemas.
¿Puedo salir de los AI Overviews sin salir de Google?
Sí. Desde el 31 de agosto de 2026, Search Console tiene en sus ajustes un control de IA generativa que permite excluir la web de los AI Overviews, del Modo IA y de las funciones de IA de Discover, sin afectar a la indexación ni a la posición en los resultados normales. Para limitar solo algunos fragmentos de una página siguen funcionando nosnippet y data-nosnippet.
¿Necesito un archivo llms.txt?
Para Google, no: su guía de optimización para IA dice que Google Search no usa archivos de texto para IA ni Markdown, y que no ayudan ni perjudican a la visibilidad. llms.txt es una propuesta de 2024, no un estándar. Si tu plugin de SEO lo genera solo, puedes dejarlo; lo que no compensa es dedicarle horas esperando aparecer más.
¿Los rastreadores de IA hacen caso a robots.txt?
Los de entrenamiento y de búsqueda de OpenAI, Anthropic y Perplexity dicen respetarlo, y Google y Apple aplican sus reglas Google-Extended y Applebot-Extended. Con los que actúan por petición de un usuario hay diferencias: Anthropic dice que Claude-User lo respeta, OpenAI avisa de que puede no aplicarse a ChatGPT-User y Perplexity reconoce que Perplexity-User en general lo ignora.
¿Qué rastreadores de IA debería bloquear una pyme?
Depende de lo que vende. Si tu web sirve para captar clientes, lo habitual es dejar pasar los rastreadores de búsqueda y decidir solo sobre los de entrenamiento. Si tu contenido es el producto, como un curso o informes de pago, tiene más sentido bloquear el entrenamiento. En ningún caso bloquees Googlebot ni Bingbot pensando en la IA: desaparecerías de los buscadores.